企业知识库RAG & LLM-WIKI混合架构方案


> 这篇想讲清三件事:RAG 在企业里跑了五六年,到底卡在哪儿;llm-wiki 那页纸换了个什么做法;以及我们为什么把两条路放进同一个系统。
今年四月,Andrej Karpathy 在 GitHub 上贴了一页纸,文件名就叫 llm-wiki。里面没有代码,没有模型参数,也没有跑分。他自己管它叫 idea file,一个想法而已。
这一页纸引出的动静不小。两周不到,star 攒了几千,社区里照着做的项目冒出来几十个,有人拿 Obsidian 加一个模型,就把自己的资料库搭起来了。跟着热闹起来的还有一句话,说 RAG 该退场了。
这个结论我们没那么着急下。RAG 在企业里跑了五六年,能干什么、在哪儿卡住,大致有数了。麻烦的地方在于,很多本来该由别的环节负责的活,被塞给了它。llm-wiki 这页纸碰巧把那些活接了过去。
## 一、RAG 干的是“找得到”
RAG 这个名字出自 2020 年 Lewis 那组人的一篇论文。工程上的做法这几年没怎么变,拆开就是四步。
文档先切成小段,一段几百字。每段交给一个模型,压成一串数字,这串数字叫向量。所有向量放进库里,建好索引。有人提问,问题也压成一串数字,去库里找出数字最接近的那些段,先捞一批候选回来。最后让重排模型给候选打分,挑出最相关的几段,塞进模型的上下文里,由它组织成答案。
向量这套东西能站住脚,靠的是一个很朴素的道理,意思相近的两段话,压出来的数字也靠得近。手册上印着“额定电流”,员工嘴里说的是“工作电流”,字面对不上,向量能对上。
它还有第二个本事,扛量。库里几十万份文档,索引建好以后,响应时间基本还是平稳的。
毛病出在别的地方。
最明显的一处是记性。同一份文档,上午问一遍,下午再问一遍,它读两遍,答完什么也不留下。两次答案的字句还可能不一样。企业里最常听见的抱怨就是“昨天它还是这么说的”。
第二处出在切片。一段话被切开以后,它不知道自己属于哪一章、哪一版、跟哪几条规定配套。比如一句“上述条款自发布之日起执行”,离开上面那行“第 4.2 条,2023 年修订”,单独拿出来什么也说明不了。前端能告诉你这句话出自哪份文档,说不出它是不是现行版。
第三处是重排的天花板。重排模型的活是在已经捞回来的候选里排序,候选之外的内容,它碰不到。所以不管重排怎么调,上限都卡在召回那一步。
塞进上下文这一步同样有上限。模型的上下文有长度限制,一次能读的内容有限,塞得越多,中间那几段越容易被它忽略。靠多捞、多塞,答案不会跟着变好。
这么一来,RAG 想做好,从切片到召回有一长串环节要调。切多大、要不要重叠、召回几路、重排拿什么数据训,哪一环偷懒,最后都堆在答案上。模型那头其实没多大毛病,功夫全耗在这些流程里。
## 二、LLM-WIKI 换了个做法,先把知识整理好
RAG 是有人来问,再回原文现取现拼。LLM-WIKI 反过来,资料进来的时候就整理,写成一篇篇互相链接的页面,相当于建立了一个知识图谱。等人提问的时候,它读到的是已经整理过的东西。
整理带来的好处,掰着指头数也就那么几条,但每条都实在。
* 一件事只有一个落点。同一份资料被十篇文章引用,不用抄十遍,改一次,全库跟着变。
* 页面自己带上下文。它属于哪个主题、跟谁相关、有没有被新结论推翻,都写在页面里,不用每次回原文去摸。
* 库会越用越厚。新资料进来是往里织,补链接、改旧结论,跟着一起长。
具体做起来也是三件事。导入时编译,新资料读进来,提炼要点,更新已有页面,改掉被推翻的旧结论,补上链接。提问时先读整理好的索引页,再往下综合。隔一段时间做一次体检,找矛盾、找过时、找没人链接的孤立页,也找还缺资料的地方。
社区里有人试过。放进一篇新文章,模型可能同时改动十到十五个页面。这跟写笔记不是一回事,你动的是整张网。他那个库有一百来篇文章、四十万字,用 Obsidian 翻,自己几乎不手写。他有句话传得很广,“Obsidian 是 IDE,模型是程序员,wiki 是代码库”。分工说得很清楚,人挑资料、定方向、判断结论,模型负责摘要、归档、建链接、改索引。
但企业的情况不一样,同一份手册可能有十个版本,几条产品线并着走,几十个人同时在改,还要分权限、留操作记录。个人库里那些顺手做法,搬到这儿就不够用了。
批评也实在。那页纸底下有人算过,库到一千个文件左右就开始吃力,页面一多,模型维护不过来。还有人担心错误会滚起来,模型写错一条,后面几十页跟着错。Karpathy 本来的定位就是个人知识库,他没打算让它直接扛企业的数据量。
## 三、两条路管的不是同一件事
| 维度 | RAG | LLM-WIKI |
| --- | --- | -------- |
| 解决什么 | 海量内容里把相关的捞出来 | 把散落的内容整理成有归属的知识 |
| 作用对象 | 文本片段和向量索引 | 知识单元和它们之间的关系 |
| 知识状态 | 每次提问临时拼,不积累 | 编译成页面,越用越厚 |
| 出处粒度 | 到片段,说清来自哪份文档 | 到章节和条目,说清归谁管、是不是现行版 |
| 成本位置 | 查询期持续支出,提问越多花越多 | 入库期一次投入,之后只碰变更的部分 |
| 规模表现 | 索引建好后,规模基本可控 | 百级来源、几百页面最好用,再往上要有检索层接手 |
两条路的差别大致在这儿,一个管内容整理到什么程度,一个管量堆上去以后还找不找得准。
一个像编书的编辑,把散稿理成有目录、有交叉引用的一本书;一个像图书馆的检索台,几十万册书随手就能取到。企业两样都要,缺哪一样,另一头都会显出问题。
## 四、ThinkWiki 的混合架构设计
ThinkWiki 这次的版本更新,把两套做法放进了一个系统。入库的时候由模型把资料整理成一条条知识单元,检索的时候还是走向量。两边各干各的,中间用同一份目录串住。
用下来最实在的好处有两个。一个是资料进库这一步有人管了,整理、校对、统一口径这些活交给智能体,人只看改动。另一个是检索拆成两层,文档再多也能先把位置找准,再回原文取整章。
整个架构从上到下五层,文档从门口进来,一层层往下走。
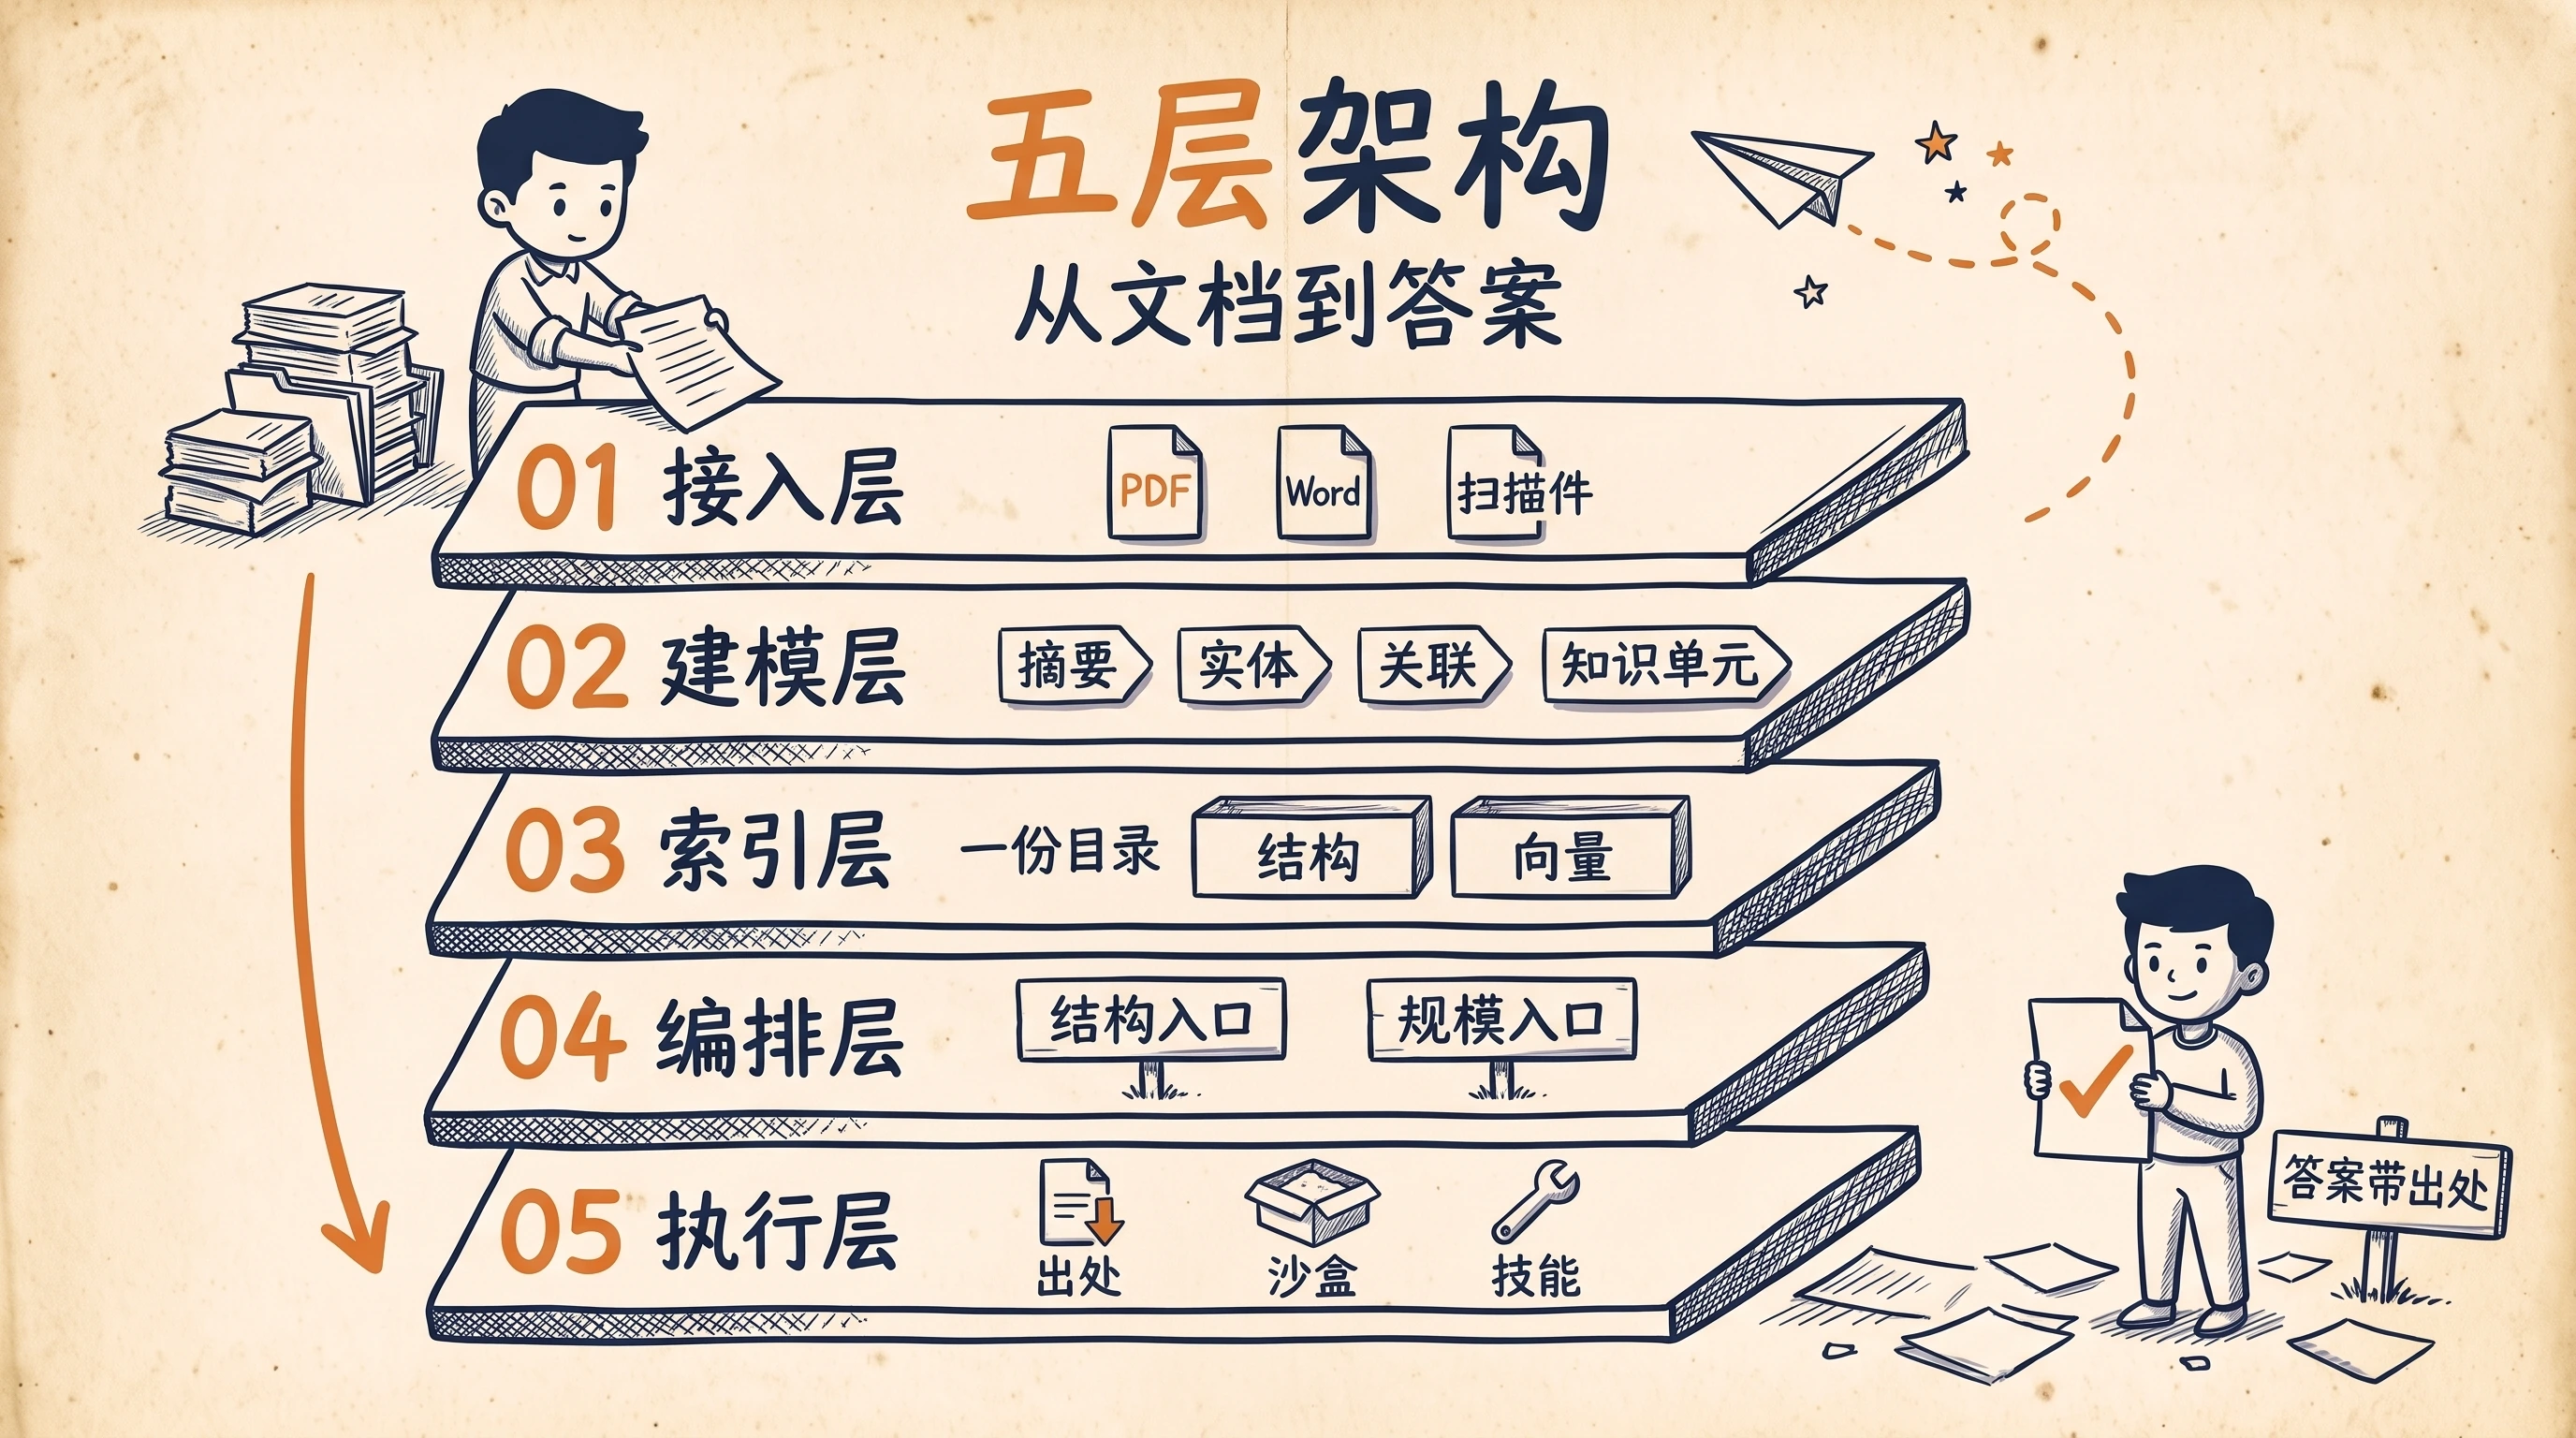
### 接入层
文档进来这一步,麻烦多半在格式。接入层先把各种文件统一解析成 Markdown,PPT、Word、PDF 都走这条路,图片和音视频也能读。干这活的是 Wiki 智能体内置的沙盒,配上文档解析工具和技能,人不用先手动转一遍格式,丢进去就行。
### 建模层
这一层对应 LLM-WIKI 的三层结构,由模型完成提炼、整理、关联和体检。
ThinkWiki 的文档本来就带目录,章节下面有条目,条目之间有父子、有顺序。知识单元顺着这层结构走,不用模型自己猜哪儿是一段完整的意思。模型在这一层补摘要、抽实体、建跨文档的关联,把散在五份文档里的同一个主题收拢到一个单元,再给过期和矛盾的内容做体检。
企业最在意的数据治理,也在这一层。统一口径、脱敏后再入库,这类事用内置沙盒和技能,和 AI 说清楚要求就能做,企业还能自己写贴合业务的治理技能。Wiki 自带编辑器,入库的知识哪儿不对,人可以当场改。RAG 那边切完就压成向量,想改也找不回原句。
### 索引层
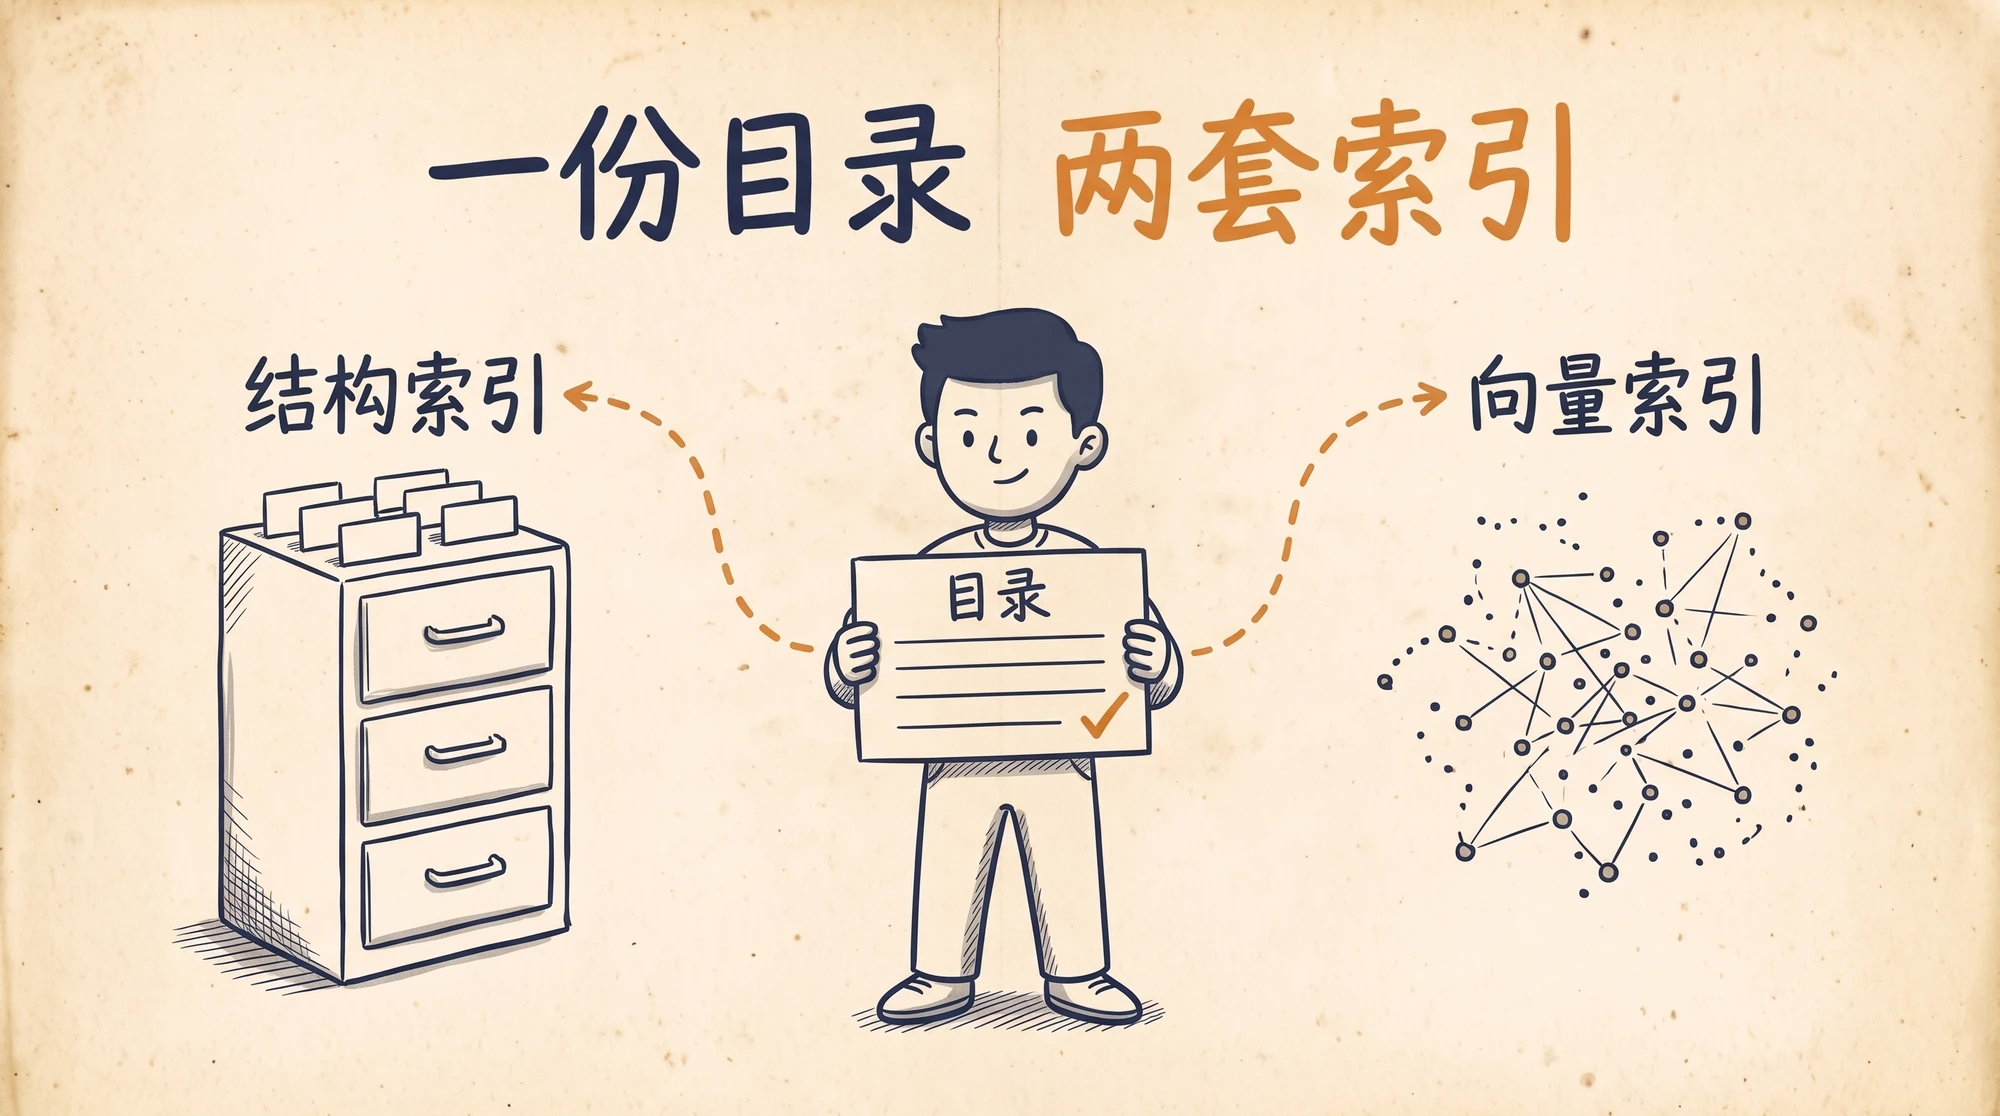
每个知识库的目录文件,本身就是一份索引。哪个库有哪些文档,每篇讲什么,主题落在哪一章,靠它导航。这张目录不用另起一套维护,它就是一份普通文档,一样会被向量化,照样进向量库。内容调整走增量索引,不会触发全库重建。
所以两套索引不各跑各的。同一份目录,一边当结构用,回答这条内容归哪一章、跟谁同级、有没有新旧两版;一边当文本用,参与语义召回,用户问得含糊的时候由它把人引到大概的位置。目录改一次,两边同时更新,不用另外跑一遍同步。
### 编排层
这层管检索,里面拆成两层。
第一层只找片段。目录、条目、正文都进过向量库,问题进来先按语义把最像的一批片段捞出来,几百字一段,每段都带着自己所属章节的标识。这一层只管一件事,捞全,宁可多带几条回来。
第二层回原文取整章。按片段上的章节标识,去原文库里把那一章整段取出来,标题、上下文、同级条目、前后顺序一起带上。切片时候被切掉的那些关系,到这一步补回去了。最后交到模型手里的,是一整章东西,有头有尾。
顺序反过来看,就知道为什么非要拆成两层。只取片段,模型看到的永远是断章,一句“上述条款”不知道指的是谁;只按章节取,又不知道哪一章跟问题有关。先让向量把落点找出来,再顺着落点把整章抱回来,两头都占住了。
### 执行层
到了执行层,就剩三件具体的事。答案里每段结论都挂着节点标识,前端能跳回原文位置。AI 要改文档,先在沙盒里改,改哪几段能预览,也可以逐段确认或撤回。检索完的稿子按模板成稿、翻译、配图,交给 Wiki 内置的技能。
## 五、企业要的其实不是知识库
如果只是站在知识库这个角度的话,定位就会比较窄,而且企业建设的欲望和动力就不足,所以ThinkWiki定位的是企业知识中台。
知识中台这个词,行业里已经有一套说得比较完整的定义。它管知识从进来到用出去的全过程,先把两种东西收在一起。一种是已经写下来的,文档、政策、数据、案例都算;另一种还留在人脑子里,员工经验、客户对话、业务诀窍。收进来以后做结构化和治理,再通过接口、问答和嵌入业务系统这几种方式送到具体场景里。
我的理解是知识库的终点不是寻找答案,而是交付业务成果,简单来说就是你得把知识接上业务才能体现价值。
理解下来大概三层意思。
第一层是把它当资产看。散在各处的文件不算资产,能被人反复调用、知道归谁管、知道是不是现行版的,才算。同一件事在五份文档里有五种说法,那不叫资产,叫负担。
第二层是把它当服务提供出去。不再等人来搜,知识以接口和问答的形式交出去,客服机器人、售前工具、业务系统直接调,改一次,各处同时生效。
第三层是贴着业务长。库建好了放着,等人有空来看看,这种用处不大。客服答疑、售前写方案、交付照手册做、新人三个月上手,用得上的才算数,用完效果还得看得见。
它和知识库最大的差别在复用上。知识库存的是文件,按份数算,存了多少 GB、多少万份文档。中台存的是知识单元,按被调用的次数算,多少个单元被几个场景在用,用完问题有没有解决。前者越存越贵,后者越用越准。
这几年见得最多的走偏,是把中台当网盘用。文档传上去,没人审、没人更新、没人认领,权限也随手一设,一年后跟当初那个共享盘没什么区别,只是贵了不少。
要判断一家企业知识中台有没有真建起来,问三个问题就够了。一份内容加工完,有几处场景在调它。答案落不落得到具体章节和现行版。权限、日志、责任人是不是清楚。三条缺一条,它迟早退回成一个共享盘。
ThinkWiki 做的是企业上下文这一层,没打算再造一个新入口。企业已经有 OA、有客服系统、有对外站点,这些入口背后共用的那批知识,才是眼下真正缺的东西,而这一层是企业AI落地的基本盘。
## 六、想试的话,从一份文档开始
整套东西没人能一次立起来,一般分三段走,每段的钱和时间都花在不同地方。
| 阶段 | 周期 | 主要工作 | 验收看什么 |
| --- | --- | ---- | ----- |
| 建模 | 两周 | 选一个场景,文档入库,把知识单元校准 | 覆盖全不全,结构能不能抽样验 |
| 检索 | 四周 | 把知识库引导进真实业务里跑 | 先看定位准不准,再看答案好不好 |
| 执行 | 四周 | 把两三条固定流程做成技能 | 不看上线几个技能,看有没有人自己主动用 |
失败的项目多半死在第一步。场景选得太大,提炼结果没人校对,后面两步全建在沙上。
今天就想动手的话,挑一份最常被追问的文档,把真实问题丢进去,看三件事。能不能定位到具体章节,答案有没有出处,出处点回去是不是最新版。哪一环断了先补哪一环,比先买一套系统实在。
> 这套架构已经在顶想云 ThinkWiki 里落地了。结构化章节负责整理,两套索引负责检索,沙盒和技能把结果交到业务手里。想验证的话可以从 [k.topthink.com](https://k.topthink.com/) 拿一份自己的文档跑一遍,私有化部署和系统对接也随时可以找我们聊。
资讯来源:https://blog.topthink.com/thinkwiki-rag-vs-llm-wiki.html
推荐资讯
-
企业知识库RAG & LLM-WIKI混合架构方案
2026年11月03日
-
企业AI到底需要记忆还是工作档案?
2026年11月03日
-
一句话造一个应用:ThinkBot「智应用」把企业 AI 落地拉进分钟级
2026年11月03日
-
PHP 重大RCE漏洞的ThinkPHP站点应对速查
2026年10月22日
-
调试技能这件事,以后可以交给 AI 自己去做了
2026年09月09日
最新资讯
-
企业知识库RAG & LLM-WIKI混合架构方案
2026年11月03日
-
企业AI到底需要记忆还是工作档案?
2026年11月03日
-
一句话造一个应用:ThinkBot「智应用」把企业 AI 落地拉进分钟级
2026年11月03日
-
PHP 重大RCE漏洞的ThinkPHP站点应对速查
2026年10月22日
-
调试技能这件事,以后可以交给 AI 自己去做了
2026年09月09日